Posts for: #Tools

GitNexus 这类工具,大概率不需要

看了一下 GitNexus,一个把代码仓库索引成知识图谱、再通过 MCP 喂给 Claude Code / Cursor / Codex 的工具。

它解决的是一个具体的人的具体问题:写大型项目的工程师,让 AI 帮忙改代码时,经常遇到 AI 改了 A 函数、没注意到 B、C、D 也调用它。一次小改动,跑起来三处崩。

为什么会这样?AI 不是不会读代码,是不知道该读哪些。Context window 再大,AI 自己也不会主动把整个仓库塞进去,成本太高。grep 能找调用方,但要 AI 自己想到去 grep,还得来回跑好几轮。调用链一深,就漏。

GitNexus 的做法是预先把每个函数、每条依赖、每条调用链都建好图。AI 要改一个函数,先查图:谁调用我、我调用谁、改了会炸到哪里。一次查询出结果,不用反复读文件。

但我的判断是,大多数人不需要装这类工具。

过去半年 Claude Code、Cursor、Codex 这批 AI coding 工具进步得很快。grep、glob、Read 这些基础工具调度得很熟,subagent 可以预先装"探索代码"的 SOP,写好一份 CLAUDE.md 把架构地图、关键模块、依赖关系交代清楚,AI 漏改调用方的事故已经少了很多。原本 GitNexus 想解决的痛,AI 工具自己在解决。

什么时候才值得试?我的顺序是这样:

先调 AI 工具本身。CLAUDE.md 写清楚架构地图、关键模块、依赖关系,subagent 装好探索代码的 SOP,每次改代码前要求 AI 先列出受影响的调用方。这些都是免费的,先做。

做完还在频繁踩坑,再考虑 GitNexus 这类工具。频繁是多频繁?一周两三次都不够,得是改代码的过程里反复出事故、CLAUDE.md 怎么写都救不回来,才值得多装一个工具。

大多数人不会走到这一步。痛感真到那个程度,往往不是 AI 工具的问题,是项目本身的复杂度已经超出了人脑+AI 配合的舒适区。那时候装 GitNexus 也只是缓解,不是根治。

所以结论很简单:先把手上的 AI coding 工具用透,再去看新工具。
[阅读全文]

Tritree:把写作变成 3 选 1 的工具

刷到一个小工具,叫 Tritree。

打开它不是给你一个空白框让你写提示词,而是 AI 一次给三个方向不同的稿子,你点一个,它接着长出下一轮三个。没选的折叠成树枝留在画布上,想回去看随时回得去。本地跑,SQLite 存数据,没登录没订阅。

作者用它写了一条微博,三轮,每轮点一下,就出来了。

herdr 是干什么的

herdr 是一个给 AI coding agent 用的终端工作区管理器。

它自己也有 workspace、tab、pane,能分屏、切换、恢复 session。只看这一层,它很像 tmux。

它和 tmux 的区别,在另一层。

tmux 管的是终端会话。herdr 除了管会话,还会识别 pane 里跑的是不是 agent,再把状态标出来。README 里列出的状态有四类:working、blocked、done、idle。

比如同时开几个 pane:

  • 一个 pane 跑 Claude Code
  • 一个 pane 跑 Codex
  • 一个 pane 跑开发服务器
  • 一个 pane 看日志

tmux 可以把这些 pane 摆好,也可以后台挂着。herdr 额外做的是:识别哪个 pane 里在跑 agent,哪个 agent 在忙,哪个在等输入,哪个已经停下来。

它判断状态主要靠两种方式。

第一种,看前台进程和终端输出。

第二种,接工具自己的 hook 或 plugin。文档里已经写明支持给 Claude Code、Codex、pi、OpenCode 装集成,这样状态报告会更直接。

除了给人看,herdr 还有本地 socket API。agent 自己也可以调用这些接口,比如:

  • 新开 workspace
  • 新开 tab
  • 分一个 pane
  • 读另一个 pane 的输出
  • 往另一个 pane 发命令
  • 等另一个 agent 完成

所以它不只是“把几个终端摆在一起”,还多了一层对 agent 的状态管理和控制。

[阅读全文]

让每个 AI 助手的对话都进我的记忆系统

我维护着一个叫 context 的个人上下文系统:一份中心 markdown,分发到 Claude Code、Codex CLI、Gemini CLI、OpenClaw 的配置路径里,保证同一个"我"在各个工具之间一致。

这个系统每天自动扫当天的对话,把我说过的偏好、决策、踩坑提炼到 OBSERVATIONS.md。问题是——它只懂 Claude Code 一家的 JSONL 格式。我同时还在用 Codex、Gemini、OpenCode,这些对话历史全都被扔在一边。

每家 AI 助手的对话都存在本地,但格式各家不同。Claude 用 JSONL,Codex 也用 JSONL 但 schema 不一样;Gemini 用整块 JSON;OpenCode 用 SQLite,message 和 part 分两张表;Cline 和 Cursor 藏在 VSCode 扩展的 globalStorage 里;Aider 干脆写在项目目录的 markdown 里。

自己从零逆向这些格式,不是我想干的活。

在 GitHub 上撞见 jhlee0409/claude-code-history-viewer,简称 CCHV。本意是个桌面历史查看器——七家 AI 助手的对话在一个界面里翻。我对桌面 app 本身不感兴趣,但它的 Rust 源码里有一个 providers/ 目录:七个文件,每家一个解析模块。每家的存储路径它替我找好了,每种格式的 schema 它替我逆向完了。

让 AI 把这部分代码翻成 Python,挪进 context 项目。

一个覆盖中文互联网的 AI Agent 人格库

GitHub 上有个项目叫 agency-agents(https://github.com/msitarzewski/agency-agents),184 个 AI agent 人格档案,分二十多个部门:工程、设计、营销、销售、财务、产品、项目管理、测试、支持、空间计算。每个档案是一个 markdown,写清楚这个 agent 的身份、工作流、交付物和成功指标。一行命令可以装到 Claude Code、Copilot、Cursor、Gemini CLI、Aider、Windsurf、Kimi Code 等十来个工具里。

同类项目不少,大多是"程序员的 Claude Code subagent 合集"。agency-agents 的不一样在两点。

一是跨工具。一套档案通过 scripts/convert.sh 生成适配各家工具的格式,不绑死在 Claude Code。这是硬工程活,大多数对手不做。

二是真的把中文互联网生态当作一级公民来写。小红书、公众号、抖音、知乎、B站、百度、微博、快手、私域(企微)、直播电商、淘系拼多多、跨境电商,还有小程序开发、飞书开发——每个平台一个专属档案。英文圈的 agent 仓库基本不碰这块。

让 AI 抽读了一遍中文生态的 13 个档案,质量良莠不齐。对这个项目的态度也简单:别整包用,挑着用。

把 CLI 订阅变成 API

CLIProxyAPI 是一个 Go 写的本地代理服务器。它把 Gemini CLI、OpenAI Codex、Claude Code 这些需要 OAuth 登录的 CLI 工具,包装成 OpenAI / Gemini / Claude / Codex 兼容的 API 端点。

装上之后,Raycast、IDE 插件、自己写的脚本都能当成标准 API 来调用,不必再走官方 CLI。支持流式和非流式响应、函数调用、多模态输入、多账号轮询负载均衡,也能把 OpenRouter 这类上游 OpenAI 兼容服务接进来。配套有 Go SDK 和管理 API。

这类工具踩在各家 TOS 的灰线上。OpenAI 和 Anthropic 都明确禁止把订阅席位用作 API 式访问或转售,多账号池化、高频率轮询、不像真人的行为画像都是风控识别的信号。最近 Claude Code 订阅号被封得比较多,原因是拿订阅额度对外跑 API 流量。Gemini 相对宽松,AI Studio Build 大规模轮询也在收紧。自用一两个号本地接客户端风险不大,池化多号对外服务就是另一回事。

项目的赞助商里挂了六七家 API 中转服务商,都是做 Claude Code / Codex / Gemini 官方渠道代理的。

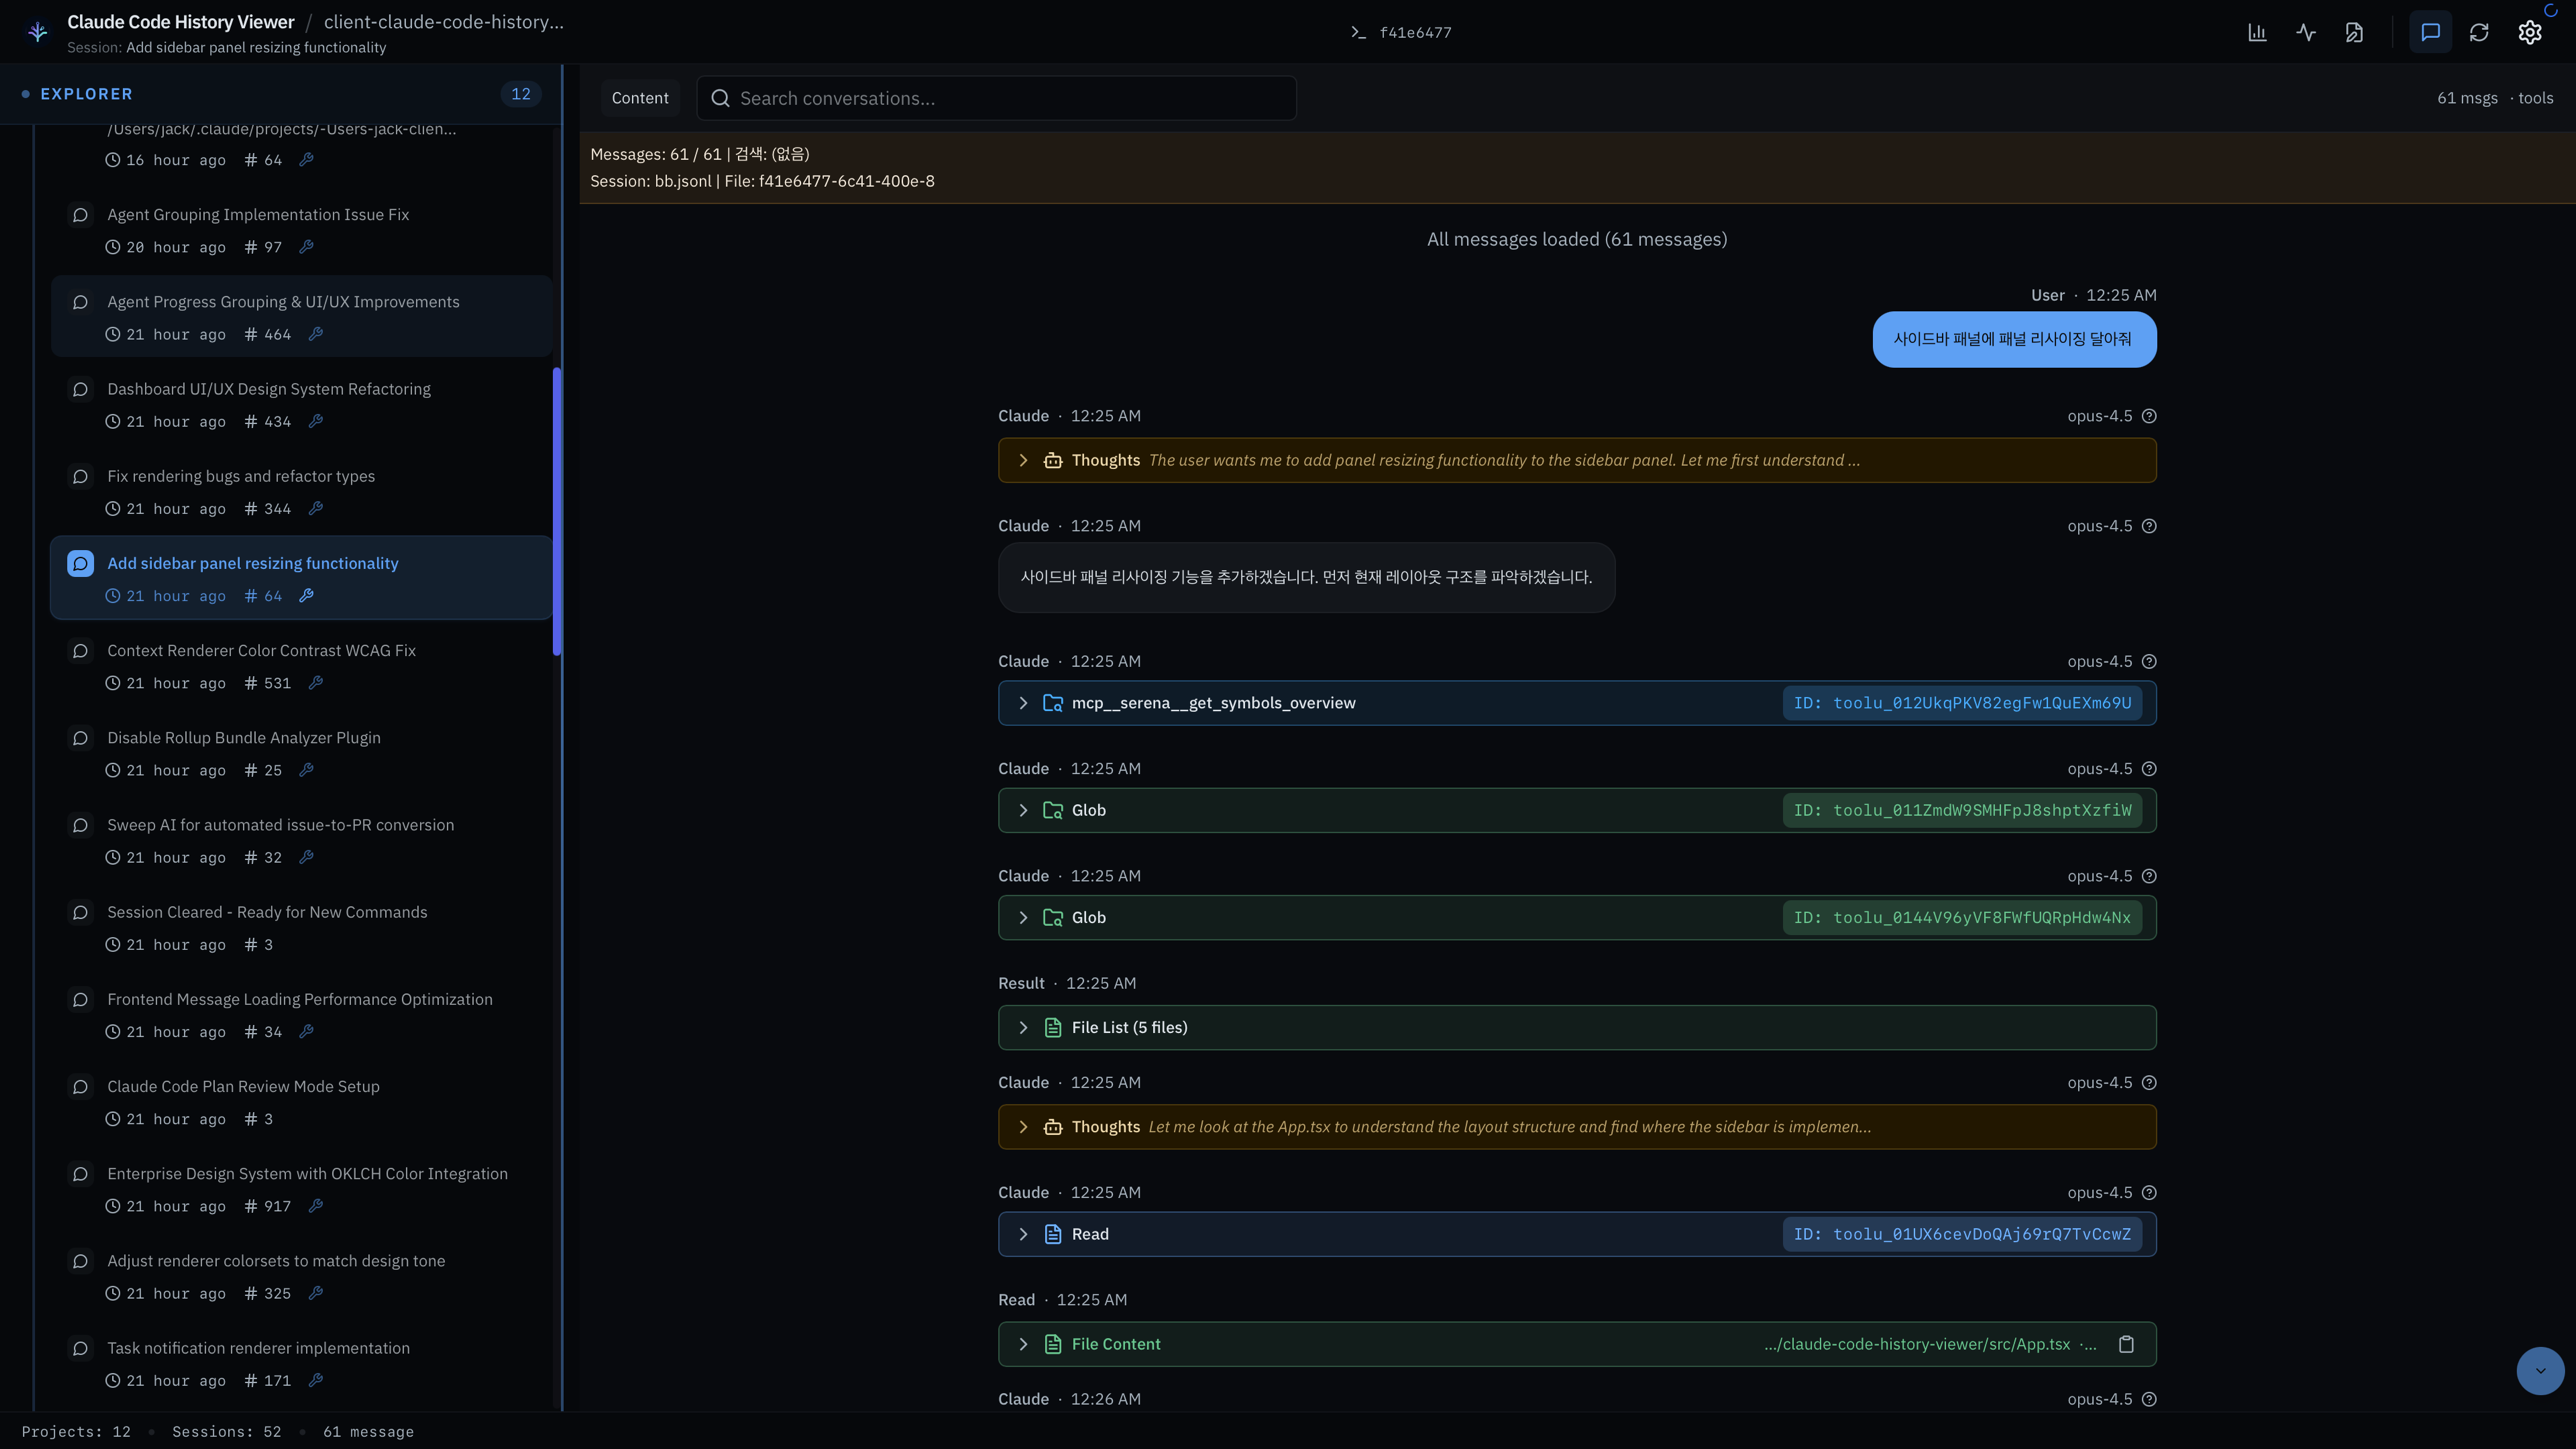
用 Claude Code History Viewer 翻自己的 AI 对话记录

同事问我平时怎么和 AI 沟通的,想看我的会话。于是推荐我用这个小工具——Claude Code History Viewer,把 Claude Code 本地 ~/.claude/projects/ 里的 JSONL 会话记录翻出来看。

截图

左边项目和会话列表,右边完整对话,Thoughts、工具调用、Token 消耗都展开。支持全文搜索,100% 本地运行。

macOS 一行装:

brew install --cask jhlee0409/tap/claude-code-history-viewer

Windows 和 Linux 去 Releases 下载。打开自动扫描,不用配置。

GBrain 双机部署实录

一台常开的台式 / 常驻机负责跑重活,一台笔记本带在身边随写随记。两台机器共用一个 GBrain,写在哪台都能在另一台搜到。

下面是我把这套装起来的实际过程,包括踩到的坑。环境是两台 Mac:M2(常开)和 M4(日常,有开有关),GitHub 账号 wulujia,笔记放 Dropbox。

架构

三层,分工明确。

Brain 仓库 = markdown 文件,源头。放 ~/Dropbox/brain/,Dropbox 负责实时同步文件,GitHub private repo 负责版本备份。

gbrain 工具 = 读 markdown、灌进索引的 CLI。每台机器独立从 GitHub clone 到非 Dropbox 路径,各自 bun link。不要让 Dropbox 同步工具源码,node_modules 跨机会掐架。

索引 = PGLite(嵌入式 Postgres),默认引擎,放 ~/.gbrain/。每台机器一份独立本地索引。markdown 是真相,索引坏了重建。

M4(日常机)从零装起

1. 装 gbrain 工具

git clone https://github.com/garrytan/gbrain.git
cd gbrain && bun install && bun link

2. OPENAI_API_KEY

到 platform.openai.com 建个 project key,丢 zshrc:

echo 'export OPENAI_API_KEY="sk-proj-..."' >> ~/.zshrc
source ~/.zshrc

注意变量名全大写 OPENAI_API_KEY。一个字母错了 OpenAI SDK 读不到,跑出来一堆 401。

[阅读全文]

GBrain 入门:给 AI agent 一个长期记忆

跟 AI 聊天有个长期的问题。每次新对话它都从零开始。聊过的想法、见过的人、读过的文章,下次对话完全空白。

GBrain 解决的就是这件事。

它是什么

AI agent 是大脑,GBrain 是它的记忆。

更准确一点:GBrain 是一堆 markdown 文件加一个搜索引擎。跟 AI 聊天时,它自己决定把什么存进去、什么取出来。存的是文本文件,可以打开看、改、备份。

这一点很重要。市面上很多 AI 记忆功能是黑盒,坏了查不出原因,也导不出来。GBrain 的记忆就是你自己的文件,放在 Git 仓库里,agent 关掉记忆也还在。

它怎么工作

三个核心动作

捕获。你跟 agent 说"今天跟老王聊了一下 SaaS 定价",一个叫 signal-detector 的技能在后台自动抽取:“老王"是人,“SaaS 定价"是话题。后台并行跑,对话照常进行。

回答前查大脑。下次问"老王最近在想什么”,agent 先搜 GBrain,翻出上次的记录,带着上下文回答。跳过这一步的 agent 等于失忆。

睡觉时整理。装上 autopilot,凌晨 agent 自动扫白天所有对话,给新出现的人建档、补社交资料、修引用。早上起来大脑比昨晚厚。

页面长什么样

每个人、每件事在 GBrain 里就是一个 markdown 文件。结构很简单:上半部写当前结论,下半部写时间线。

比如"老王"这一页。

上半:老王是某某公司 CEO,擅长 SaaS 定价,2026 年 3 月开始考虑出海日本。

下半:

  • 2025-01-10 邮件里第一次提到
  • 2025-08-22 聊过定价策略
  • 2026-03-05 说要出海日本

上半随时重写。下半只加不删,是证据链。好处是:问一个问题,agent 直接读上半部就知道答案,不用每次把所有历史再推理一遍。

怎么装

前提是装了 bun。然后两行:

git clone https://github.com/garrytan/gbrain.git && cd gbrain && bun install && bun link
gbrain init

默认用嵌入式 Postgres,零配置。接到 Claude Desktop 或 Claude Code 之后,正常聊天它就正常往里存。Gemini CLI、Codex 也能接,都走 MCP 协议。

[阅读全文]

给 AI Agent 瘦身

我的 OpenClaw 跑了几个月,token 账单越来越肥。今天花了一个小时做了一轮瘦身,效果不错,记录一下。

核心发现很简单:很多任务根本不需要 AI 参与,但它们都在 AI 会话里跑。每跑一次,哪怕只是执行一句 bash 命令,也要启动一个 session、加载 context、消耗 token。相当于你请了一个年薪百万的工程师,每天的工作是帮你按一下回车键。

具体做了四件事。

第一,降低心跳频率。Agent 有一个 heartbeat 机制,定时唤醒做巡检。我之前把 OpenClaw 设成 8 小时一次,配置没真正生效,实际还是一天 24 次。改成 12 小时一次,一天 2 次。心跳的作用是维护 context、检查状态,2 次够了。

第二,把纯 shell 任务迁出 AI。安全巡检、日志整理、会话记录提取、GitHub 同步、版本检查这些任务,本质都是跑一个 shell 或 Python 脚本。之前放在 OpenClaw 里,执行链路是:cron 触发 → 启动 AI session → AI 理解 prompt → AI 调用 bash → 收集输出 → AI 总结输出 → 发通知。现在改成:crontab 触发 → 跑脚本 → 有输出就用 Gmail API 发邮件。中间砍掉了 AI 理解和总结两步,对这类任务毫无价值。

[阅读全文]