Posts for: #AI

图灵测试:背景、方法、意义和现状

背景

1950 年,图灵在《Mind》杂志发表《计算机器与智能》。他开头就说,“机器能思考吗”这个问题太模糊,没法回答,于是换了一个可以动手做的实验,叫“模仿游戏”。那一年,全世界能跑的电子计算机只有几台。

方法

一个人当裁判,用文字和两个看不见的对象聊天,一个是人,一个是机器。裁判想问什么都行。聊完,裁判猜哪个是机器。

图灵的预言是:到 2000 年,聊五分钟后,普通裁判猜对的概率不超过 70%。也就是说,机器能骗过三成裁判,就算过关。

只用文字,是这个设计的关键。声音、长相、身体都被挡在外面,剩下的只有对话本身。

意义

它给人工智能定了第一条终点线:只要表现得和人分不出来,就算智能。它绕开了“什么是思考”的哲学争论,只看行为。

反对的人也是围着它打。1980 年塞尔提出“中文房间”:一个不懂中文的人,照着规则手册处理中文纸条,也能让房间外的人以为里面有个懂中文的人。他的结论是,通过测试不等于理解。今天关于大模型“懂不懂”的争论,还是这个框架。

现状

早期的“通过”都是取巧。1966 年的 ELIZA 靠模板套话,骗过了一些人。2014 年的 Eugene Goostman 假扮一个 13 岁的乌克兰男孩,英语不好有了借口,骗过了三成裁判。业内没人把这两次当真。

大模型改变了局面。2025 年加州大学圣地亚哥分校做了一次三方测试,五分钟对话,GPT-4.5 在被要求扮演一个具体人设时,有 73% 的裁判把它当成了人。这个比例高于同场真人。多数研究者现在认为,经典图灵测试已经过了。

过了之后,大家发现它测的东西比想象中少。同一批模型在长任务规划、稳定推理、承认自己不知道这几件事上仍然会翻车。聊天像人和做事靠谱,是两回事。

这个领域已经转向更难的考题:数学和编程题、跑几个小时的代理任务、裁判有几周而非五分钟的“长图灵测试”。还有人把问题反过来:现在难的是在网上证明你是人。

图灵画的那条终点线,我们在 2024 到 2025 年之间跨过去了,然后发现它是起跑线。
METR:经费、团队与非营利研究机构是什么意思

METR(Model Evaluation & Threat Research,读作 meter)是一家评估前沿 AI 模型能力与灾难性风险的美国非营利研究机构。本页回答三件事:它说的 “nonprofit research institute” 在法律上是什么意思、钱从哪来、谁在做。

取样截至 2026-09-14主要来源:metr.org About / 博客地点:Berkeley, CA

先说结论

METR 是美国联邦税法下的 501(c)(3) 免税慈善机构,法人名 Model Evaluation and Threat Research,EIN 99-1219864;没有私人股东,盈余留在使命内。 生存主要靠捐赠:2024 年 10 月 The Audacious Project 促成的 Canary 合作里,约 3800 万美元总额中约 1700 万美元支持 METR;2026 年 8 月 14 日自报过去 6 个月获得约 7100 万美元承诺。 创始人兼 CEO 是 Beth Barnes(2022 年离开 OpenAI,先在 Alignment Research Center 下做 ARC Evals,2023 年 12 月独立并改名 METR);领导层还有 President Chris Painter、Chief Scientist Hjalmar Wijk、CTO Nate Rush。

[阅读全文]

一个人训一个小模型:成本、步骤和真正的难点

42 章经 8 月 29 日那期,曲凯对谈逯雨鑫。他不是 AI PhD,也没在 AI Lab 待过,用一张显卡、两周、几百美元后训出的小模型两次登上 Hugging Face 热度榜第一。

这期没有文稿,小宇宙上这档节目关掉了官方 AI 转录,所以我把音频扒下来让 whisper 转了一遍,再把方法整理成下面这份可以照着做的清单。转录是机器做的,数字和英文名词我做了批量校正但没有逐句核对,最后一节列了几处没听清的地方。

他到底做了什么

  • 基座是 Gemma 3 12B,老师模型是 Fable 5(他估算 3T 参数以上),做法是拿老师的回答喂给小模型,也就是蒸馏加监督微调(SFT)。
  • V1 用了 5 天,其中 3 天做数据、1 天训练。V2 用了两三周,其中 12 天在做数据。
  • 硬件是一张 5090,方法是 QLoRA。真正跑训练只有十几个小时。另有一份 200 美元的 Claude Max 订阅,用来合成靶向数据。总成本几百美元。
  • 效果:在 agentic 工具调用类的基准上,原版 15 分,训完 55 到 60 分。代价是其他基准或多或少掉分。

这条路只有一个衡量标准:模型在你那一个场景里是不是更好用了。全局变聪明是 AI Lab 的事。

六步

第一步,先想清楚要做什么。他强调不要看什么火做什么,热的方向竞争对手也多。做应用的就围绕自己的业务想。目标不明确,后面每一步都无从判断对错。

第二步,选基座模型。中文场景直接选 Qwen,他说 Qwen 是坑最少的,训练脚本、部署、周边工具都最全。Gemma 3 12B 的中文很差,不管哪个量化版本,大部分时候会往粤语上飘。Llama 4 和最近那个 30B 的模型架构不主流,训起来会很麻烦。

[阅读全文]

AI 写代码快了,产品迭代还慢,怎么办?

从需求到上线,每阶段的产出、做法和效果。

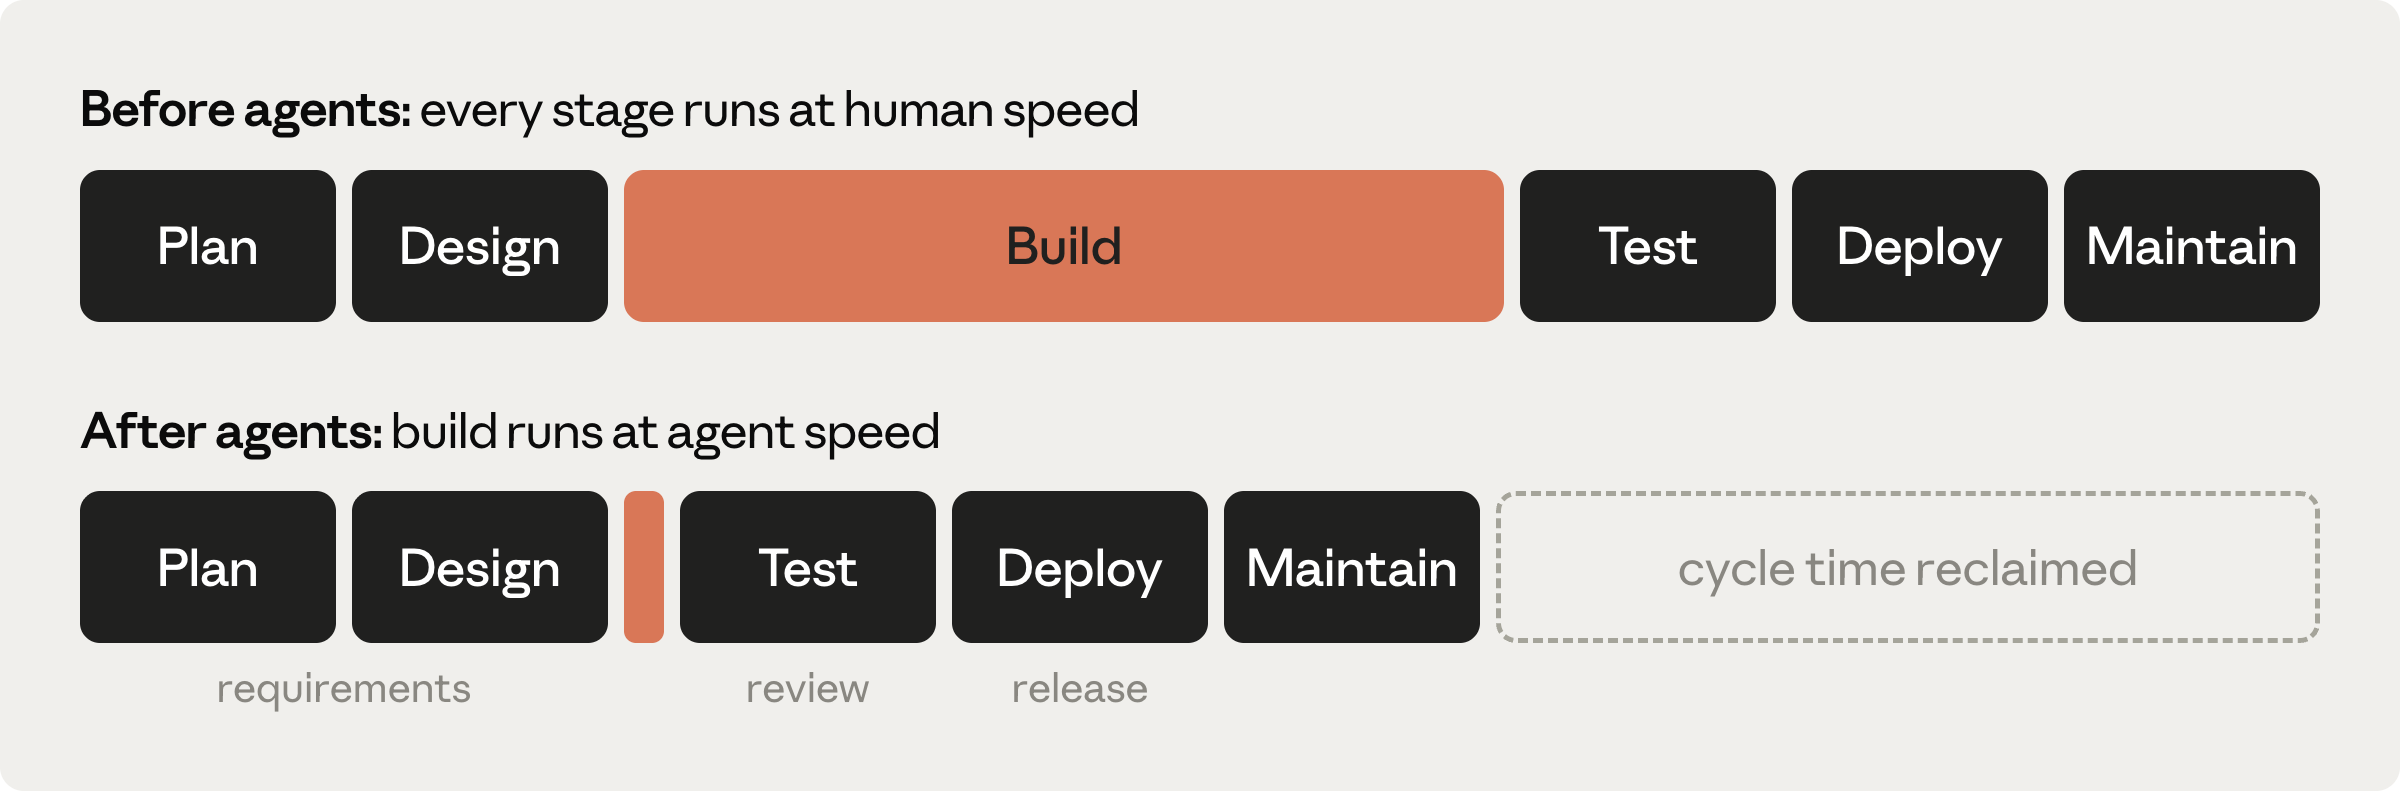
AI 写代码变快后,需求、审查和发布也要提速。每阶段留下产出,下一阶段接着做;人负责目标和批准。

原课图片:AI 缩短了写代码的时间,需求、检查和发布仍然耗时。

原课图:瓶颈转移,长度为示意。

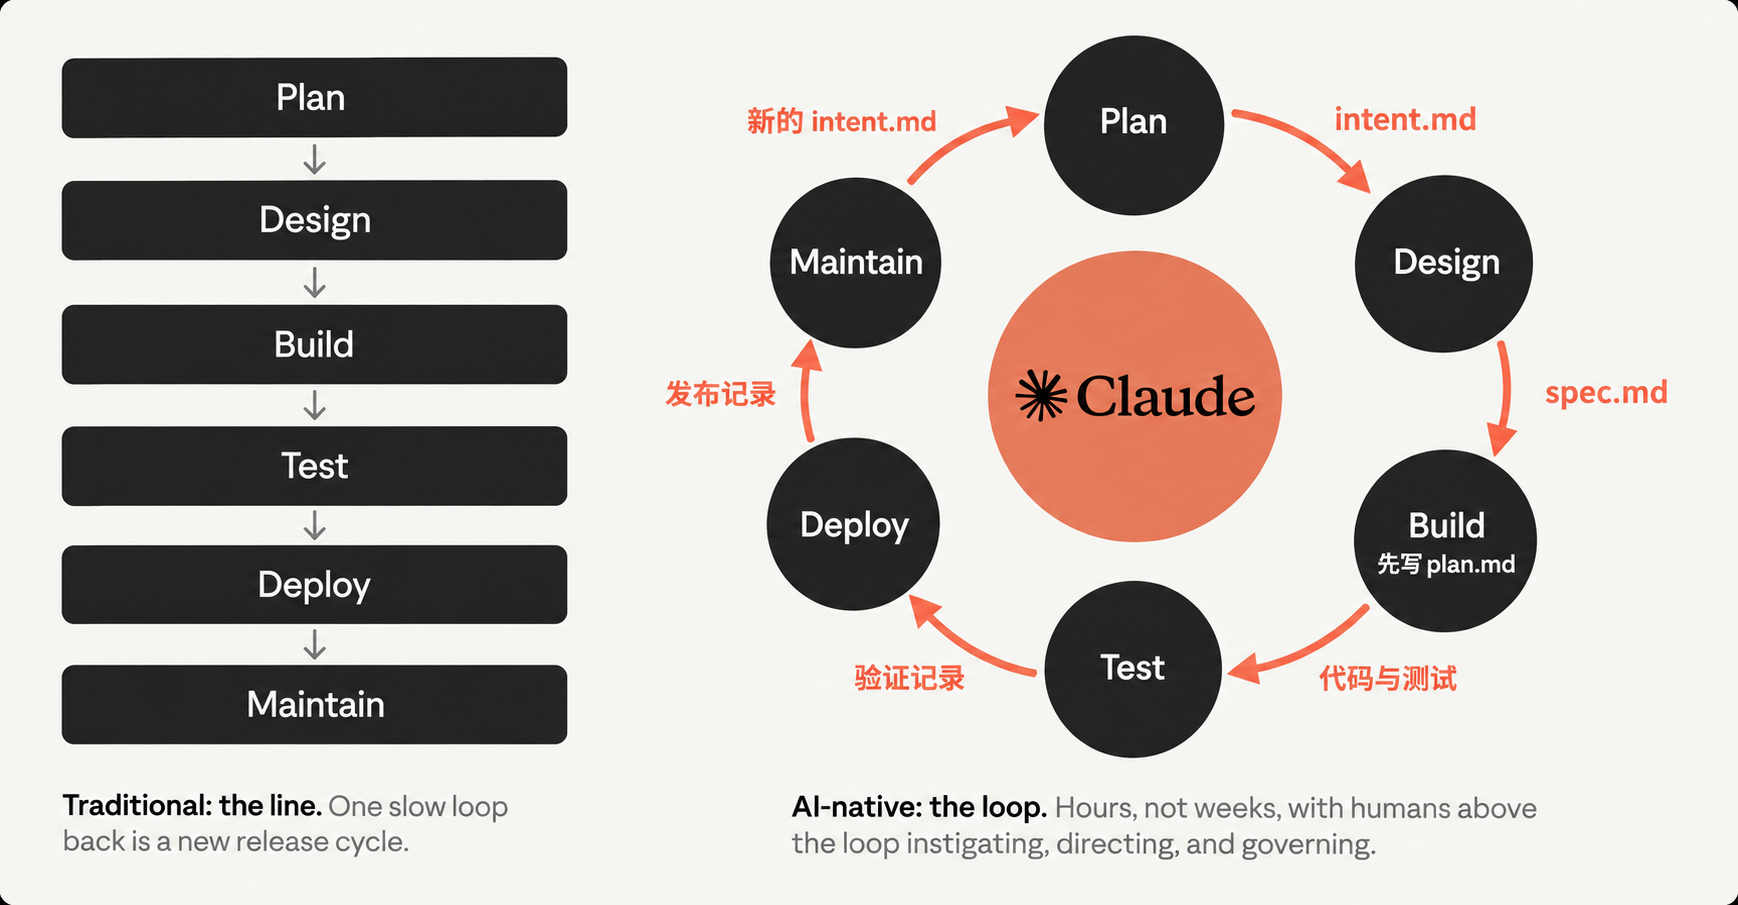
intent.md 记“要什么”,spec.md 记“定了什么”,plan.md 记“怎么做”。计划阶段明确需求;实施计划在构建阶段产生。文件、代码及批准记录都进入版本管理。

计划阶段|产出:intent.md

提想法的人与 AI 讨论问题、目标和限制,AI 起草需求,产品负责人纠正并批准。例如:“客户能在网页上查理赔进度,沿用现有登录方式。”

看效果:需求提交耗时、获批比例,以及设计开始后需求修改次数。

设计阶段|产出:spec.md

AI 读 intent.md,按团队规范写方案,标出冲突和疑问。产品负责人解决并批准,高风险请技术负责人参与。

看效果:从需求到方案用了多久,开发后因需求不清返工几次。

构建阶段|产出:plan.md 与代码

AI 读已批准的 spec.md 和代码,先写 plan.md:改哪些文件、实施顺序、如何验证。工程师批准后再写代码和测试;偏离计划时同步更新。

看效果:一次实现即可合并的比例、合并耗时、返工次数。

测试阶段|产出:验证记录

AI 跑测试、构建及页面检查,失败就修,留下输出或截图。修 bug 先用测试复现,并保护测试,防止放宽检查。

看效果:首次检查通过率、人工审查耗时、上线后的改动失败率。

部署阶段|产出:发布记录

AI 按审查规则检查并修复问题。代码负责人批准合并,发布负责人授权上线。变更请求(PR)和部署日志留下审查、批准与执行结果;回滚须提前演练。

看效果:首次审查等待时间、意见自动修复比例、漏到线上的缺陷数。

维护阶段|产出:新的 intent.md

监控触发 AI 排查,将证据、影响和修复目标写成新需求。负责人决定修复、排期或关闭。修复照常走验证和审批,事后补防复发案例。

看效果:异常到需求入队耗时、发现转成修复的比例、同类故障复发次数。

圆圈表示阶段,连线标注交接产出:Plan 到 Design 为 intent.md,Design 到 Build 为 spec.md,Build 到 Test 为代码与测试,Test 到 Deploy 为验证记录,Deploy 到 Maintain 为发布记录,Maintain 到 Plan 为新的 intent.md。Build 内先写 plan.md,再实现代码。

据原课图补充阶段产出。

[阅读全文]

TeamAI:给 AI 编程工具加一层团队协作

TeamAI 是腾讯开源的命令行工具。它把 Claude Code、Cursor、Codex、CodeBuddy 等 Agent 的 skills、rules、hooks、MCP 和团队知识放进一个共享 Git 仓库,通过评审后同步到成员本机。

资料日期:2026-09-08。功能与命令来自项目文档;Stars、Forks、Issue 数量是当天快照,未实际安装验证。

协议快照版本技术栈
MIT约 1.7k Stars、121 Forks0.22.0TypeScript / Node.js

它解决什么问题

个人 Agent 已经能做很多事,但一次踩坑、一个有效的 skill,常常只留在某个人的电脑上。不同工具的配置路径不一致,MCP 和 hooks 也难统一管理。

TeamAI 把这层团队工作方式放进 Git:团队维护 Harness(skills、rules、agents、hooks、MCP、env 等)和 learnings;成员通过 pull 获取更新;新增内容经 Merge Request 评审后再分发。它也会收集摩擦信号,支持回顾、周报和看板。

它不提供模型推理,也不是 Cursor、Claude Code 或 Codex 的替代品。它运行在这些工具旁边。

三层能力

层要解决的问题命令或功能
Team Execution让每个 Agent 使用团队约定init、pull、push;skills、rules、agents、hooks、MCP、env、packages
Team Context让 Agent 理解团队背景recall、learnings、代码库图谱、teamwiki、culture.md
Team Improvement把执行中的经验带回团队摩擦信号、session save、digest、dashboard、KB Health

分发与管理还包括 Roles、Tags、Sources、Packages 和 skill exclude。

[阅读全文]

Bark 是什么:给 iPhone 推自定义通知的极简通道

开源 App + 可选自建后端,用一条 HTTP 请求把消息打到系统通知栏。对「AI agent 跑完任务提醒我」这种场景,往往比钉钉/飞书/Telegram 机器人更短、更贴锁屏。

iOS onlyHTTP → APNs开源 + 免费
接收端是 Bark App(系统推送)你发请求,后端转苹果推送App 与 bark-server 均开源;公共服长期维护承诺

一句话

Bark(Finb/Bark)是一款 iOS App:装好后你会得到一个设备 key,之后任何脚本/服务器/Agent 只要访问类似 https://api.day.app/你的key/标题/内容 的 URL(或 POST JSON),消息就会以系统推送出现在 iPhone 上——App 不必一直在前台跑。

它解决的不是「团队 IM」,而是「把事件打到我自己的手机锁屏」。所以你说适合 AI agent 任务完成推送,方向是对的。

它怎么工作

步骤内容
1 · APPApp Store 装 Bark,打开拿到 device key(也可扫码/复制推送 URL)。
2 · 请求脚本对公共服 api.day.app 或自建 bark-server 发 GET/POST。
3 · 转发bark-server 把消息交给 Apple APNs(系统推送通道)。
4 · 到达iOS 弹出通知;可分组、点按跳 URL、归档历史等。

相对「自己接 APNs」:你不用管苹果开发者证书、HTTP/2、token 刷新。公共 Bark 把这些藏在 App/官方后端里;自建时多数人仍可继续用官方 App 的 APNs 能力(按项目文档部署 bark-server)。

[阅读全文]

从 Omarchy 截图,贴进远程 Mac 上的 herdr

问题

我的日常是:坐在 Linux(Omarchy)前面,ssh 到 Mac,在 Mac 上跑 herdr,里面开 Claude Code / Codex。

在 Linux 上截图,想贴给 agent 看,贴不过去。没有报错,没有 [Image #1],什么都没发生。

原因

SSH 只传文字。截图在 Linux 的剪贴板里,Mac 根本看不到。

ssh mac 之后再运行 herdr,herdr 整个跑在 Mac 上。它读的是 Mac 的剪贴板,不是我面前这台机器的。

这不是 Omarchy 的问题,也不是 herdr 的 bug。是架构决定的。

解法:反过来跑

在 Linux 上也装一个 herdr,用它作为客户端去连 Mac:

herdr --remote username@host

这样 herdr 客户端在 Linux 上运行,UI 从 Mac 那边流过来。剪贴板在本地,所以图片可以桥接过去:按 Ctrl+V,herdr 把 PNG 通过 SSH 传到 Mac,再把 Mac 上的文件路径贴进 agent 的输入框。agent 读路径就行。

谁跑在哪

这样做以后 herdr 两边都有,但分工不一样:

[阅读全文]

让 AI Agent 帮你运营知识星球:官方 CLI 新版发布

经营一个知识星球,每天都有一串小事。

新主题要看,评论要回复,提问不能漏掉。内容积累多了,还要整理精华、标签和专栏。到了周末,可能还要做周报、挑选好内容、制作海报,提醒即将到期的成员续费。

每件事都不复杂,加在一起很占时间。

知识星球开放平台最近发布了新版本:

  • zsxq-cli:0.5.0
  • zsxq-skill:2.1.0
  • MCP Service:近期功能更新

zsxq-cli 负责读取和操作知识星球,zsxq-skill 告诉 AI Agent 什么时候使用哪些能力。安装以后,星主可以直接用自然语言安排工作。

比如:

找出最近一周还没有回答的高质量提问,参考我过去写过的相关内容起草回答,先给我确认,明天上午十点发布。

Agent 会读取最近的提问,搜索星主过去发布的内容,整理回复草稿。星主确认以后,它再创建定时回答任务。

还可以这样说:

  • 看看今天有哪些新内容、提问和评论需要处理。
  • 整理最近的评论,找出还没有回复的问题。
  • 从本周内容里挑选值得加精的主题,并建议标签。
  • 把最近发布的主题收录到对应专栏。
  • 做一份本周运营报告。
  • 把今天的精选内容做成海报。
  • 把一篇帖子做成竖版视频。
  • 找出即将到期的成员,起草续费关怀内容。

这次更新还增加了普通主题、问答和投票主题,支持 Markdown 正文和 AI 创作声明。Agent 可以定时发帖、定时回答,查看、修改和取消定时任务,也可以设置主题精华和置顶,修改星球名称、简介、背景图和亮点图片。

在你的 Agent 里安装

知识星球 Skill 可以配合国内常见的 AI Agent 使用,包括 WorkBuddy、QoderWork、CodeBuddy、Qwen Code、Kimi Code CLI、MiniMax Code、TRAE、通义灵码等。Codex、Claude Code、Cursor 等工具也可以使用。

我们还做了一个知识星球花园,用来放知识星球和 AI 结合的新项目。这里可以查看 Skill 的能力、安装方法、离线安装包和开源代码。

让一千朵花先开。

安装不用自己研究命令。打开正在使用的 Agent,把下面这句话发给它:

帮我安装知识星球 Skill:https://garden.zsxq.com/skill/INSTALL.md

Agent 会读取安装说明,检查环境,安装 zsxq-cli 和 zsxq Skill。

登录时,Agent 会给出一个授权链接和验证码。用户在浏览器或手机里确认授权,Agent 随后检查安装和登录状态。

[阅读全文]

在手机上用自己电脑里的 AI Agent

DeepSeek 开源了自己的 agent harness,叫 dsh。装上跑一条命令就能用:

npx @deepseek-ai/dsh web

它没有终端界面,只有浏览器 UI,默认起在 http://127.0.0.1:3080。我想在手机上也能用——躺着的时候给它派个活,回到电脑前看结果。

不要直接开放到局域网

第一反应是把它绑到 0.0.0.0,手机连同一个 wifi 就能访问。dsh 直接拒绝了这个参数,报错写得很直白:

--host 0.0.0.0 is intentionally not supported yet for safety: it would expose remote code execution to the network

这不是没做完,是故意堵死的。这类 agent 能跑 shell、能读写你整个文件系统,而它目前没有任何用户认证。裸奔在局域网上,等于把电脑的 shell 交给任何连了你 wifi 的人。

用 Tailscale 反代

正确的做法是:程序继续只绑本地回环,前面放一层带认证的代理。Tailscale 正好干这个。

# 1. 启动,同时声明信任的域名
dsh web --trusted-host 你的机器名.你的tailnet.ts.net

# 2. Tailscale 在前面反代
tailscale serve --bg 3080

完事。手机连上 Tailscale,打开 https://你的机器名.你的tailnet.ts.net/ 就能用,自带 HTTPS 和设备级认证,家里 wifi 上什么都没暴露。

[阅读全文]

AI 抹平信息差之后,知识星球怎么改产品

AI 让信息不值钱了。星球上靠「我知道你不知道」收费的模式会塌,靠「你信我这个人」的模式会更强。产品怎么改,还是往人靠、往社区靠、往工具靠这三个方向。

往人靠,核心是让创作者更真。现在打开一个星球,只看到一堆帖子和一个头像。这个人靠不靠谱、什么风格、能跟多久,没有答案。可以在主页上展示他在这里几年了、回答过多少问题、成员续费率多高。信任需要时间,时间需要被看见。再进一步,把创作者说过的判断和后来的结果对照出来,错了就认的记录比一百篇对的文章更有说服力。

Substack 的做法可以参考。它的创作者主页很干净,一个大头像、一段简介、所有文章和 notes 按时间排列。它的推荐算法优化目标是订阅和付费转化,不优化停留时长。平台在帮用户找「值得长期关注的人」。方向跟知识星球想要的一致。

OnlyFans 的用户付费,很多图的是创作者直接跟你聊天、记住你的名字。平台把聊天做成了第一大功能,也是第一大付费驱动力。国内环境不同,但用户愿意为「这个人看见我了」付钱,这个道理通用。

往社区靠,核心是让成员从围观变成参与。多数星球是星主讲、大家听。可以先做两件事:让成员之间有发现彼此的机制,轻匹配一下就够了;降低第一次互动的门槛,比如增加一个「有启发」的反馈按钮,比赞更具体。点了之后星主能看到,可能顺手回一句。破冰了,人和人的距离就近了。

Substack 的 Chat 功能是付费订户专属的深层讨论,和公开的 Notes 分开。Discord 的频道分角色、分权限,成员进来之后有一个清晰的路径:先围观、再发言、最后变成参与者。知识星球目前缺的就是这条路径。

小红书有一个设计值得看:算法会把旧内容推给新用户,不只看发布时间。星球里大量好帖子几周就沉了,如果平台主动把老内容推给新成员,星主不用每天生产新东西,内容自己就有生命力。这比逼着星主日更可持续得多。

往工具靠,核心是 AI 干活、人做决定。AI 该做的:帮星主整理内容、发现值得回复的问题、提示哪些成员很久没互动了;帮沉睡的好内容再流通,用户提一个具体问题,AI 从历史帖子里找相关的内容,星主确认后推送;帮新人快速找到同好和值得先看的东西。AI 不能做的只有一件:以星主的口吻说话。宁可在功能上标注「AI 整理的参考」,也不要去模糊这条线。

Discord 开放 API 让 Midjourney 在它上面搭出了完整的产品——生成图片、管理队列、支付结算,Midjourney 没有自己做 app。知识星球也可以把能力开放出去,让外部开发者甚至成员自己搭出新玩法。笔记 914 写的「让一千朵花先开」,就是这个意思。

三个方向背后是同一个问题:这个功能做完,星球里的信任变多了还是变少了。变少了就砍。